


Using pyAgrum
 |  |  |
import numpy as npimport matplotlib.pyplot as pltInitialisation
Section titled “Initialisation”- importing pyAgrum
- importing pyagrum.lib tools
- loading a BN
import pyagrum as gumimport pyagrum.lib.notebook as gnb
gnb.configuration()| Library | Version |
|---|---|
| OS | posix [darwin] |
| Python | 3.14.8 (main, Sep 30 2026, 17:55:09) [Clang 21.0.0 (clang-2100.3.34.2)] |
| IPython | 9.17.1 |
| Matplotlib | 3.11.2 |
| Numpy | 2.5.3 |
| pyDot | 4.0.1 |
| pyAgrum | 3.2.1 |
bn = gum.loadBN("res/alarm.dsl")gnb.showBN(bn, size="9")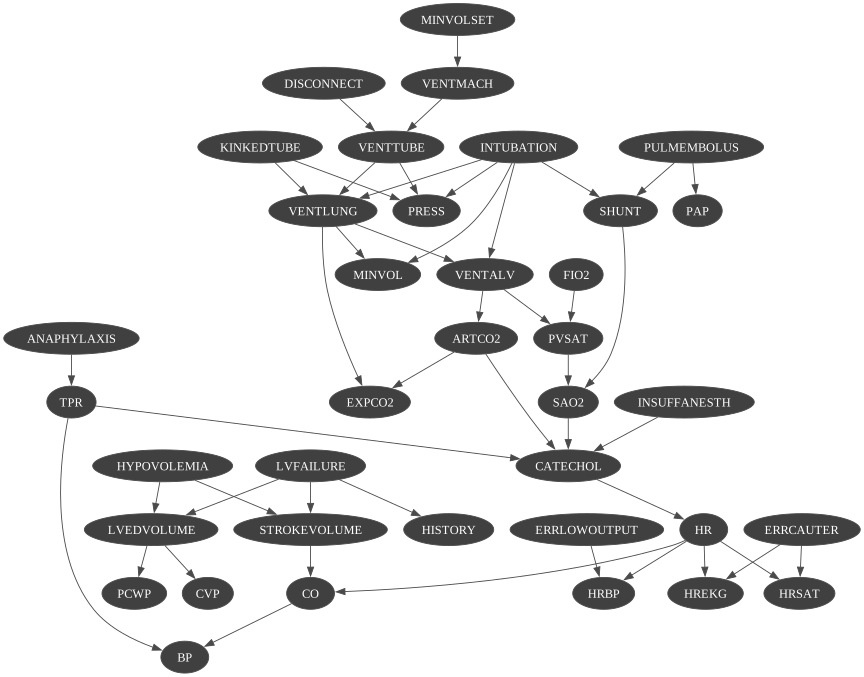
Visualisation and inspection
Section titled “Visualisation and inspection”print(bn["SHUNT"])SHUNT:Labelized({NORMAL|HIGH})print(bn.cpt(bn.idFromName("SHUNT"))) ║ SHUNT │PULMEM│INTUBA║NORMAL │HIGH │──────│──────║─────────│─────────│TRUE │NORMAL║ 0.1000 │ 0.9000 │FALSE │NORMAL║ 0.9500 │ 0.0500 │TRUE │ESOPHA║ 0.1000 │ 0.9000 │FALSE │ESOPHA║ 0.9500 │ 0.0500 │TRUE │ONESID║ 0.0100 │ 0.9900 │FALSE │ONESID║ 0.0500 │ 0.9500 │gnb.showTensor(bn.cpt(bn.idFromName("SHUNT")), digits=3)|
|
| ||
|---|---|---|---|
|
| 0.100 | 0.900 | |
| 0.950 | 0.050 | ||
|
| 0.100 | 0.900 | |
| 0.950 | 0.050 | ||
|
| 0.010 | 0.990 | |
| 0.050 | 0.950 | ||
Results of inference
Section titled “Results of inference”It is easy to look at result of inference
gnb.showPosterior(bn, {"SHUNT": "HIGH"}, "PRESS")
gnb.showPosterior(bn, {"MINVOLSET": "NORMAL"}, "VENTALV")
Overall results
gnb.showInference(bn, size="10")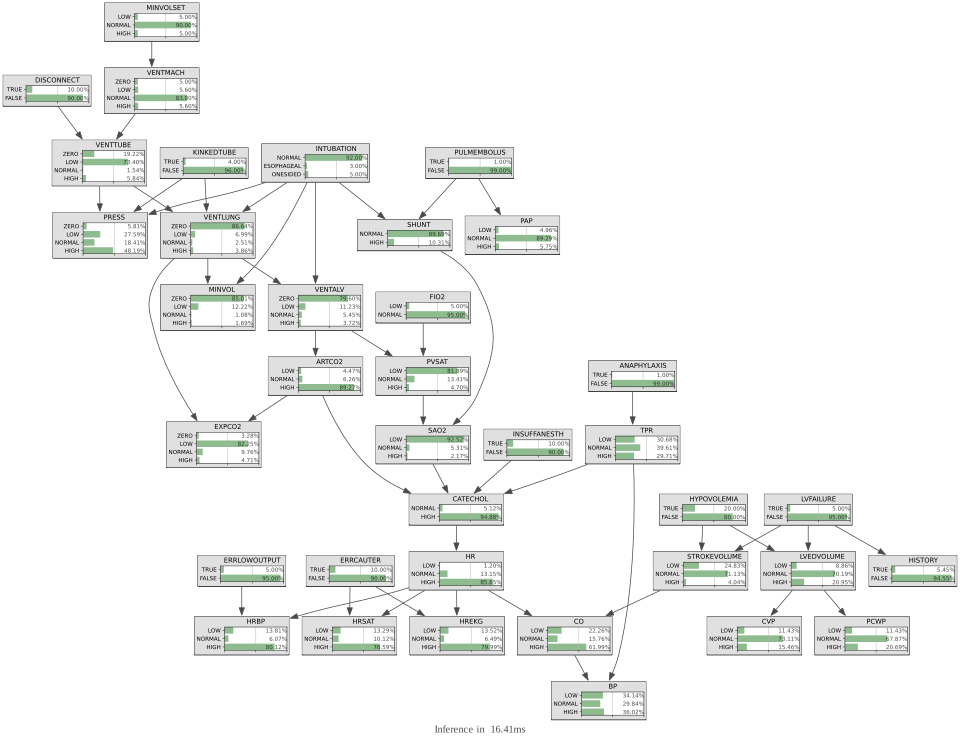
What is the impact of observed variables (SHUNT and VENTALV for instance) on another on (PRESS) ?
ie = gum.LazyPropagation(bn)ie.evidenceImpact("PRESS", ["SHUNT", "VENTALV"])|
|
|
|
| ||
|---|---|---|---|---|---|
|
| 0.0569 | 0.2669 | 0.2005 | 0.4757 | |
| 0.0208 | 0.2515 | 0.0553 | 0.6724 | ||
| 0.0769 | 0.3267 | 0.1772 | 0.4192 | ||
| 0.0501 | 0.1633 | 0.2796 | 0.5071 | ||
|
| 0.0589 | 0.2726 | 0.1997 | 0.4688 | |
| 0.0318 | 0.2237 | 0.0521 | 0.6924 | ||
| 0.1735 | 0.5839 | 0.1402 | 0.1024 | ||
| 0.0711 | 0.2347 | 0.2533 | 0.4410 | ||
Using inference as a function
Section titled “Using inference as a function”It is also easy to use inference as a routine in more complex procedures.
import time
r = range(0, 100)xs = [x / 100.0 for x in r]
tf = time.time()ys = [gum.getPosterior(bn, evs={"MINVOLSET": [0, x / 100.0, 0.5]}, target="VENTALV").tolist() for x in r]delta = time.time() - tf
plt.plot(xs, ys)plt.legend([bn["VENTALV"].label(i) for i in range(bn["VENTALV"].domainSize())], loc=7)plt.title("VENTALV (100 inferences in %d ms)" % delta)plt.ylabel("posterior Probability")plt.xlabel("Evidence on MINVOLSET : [0,x,0.5]")plt.show()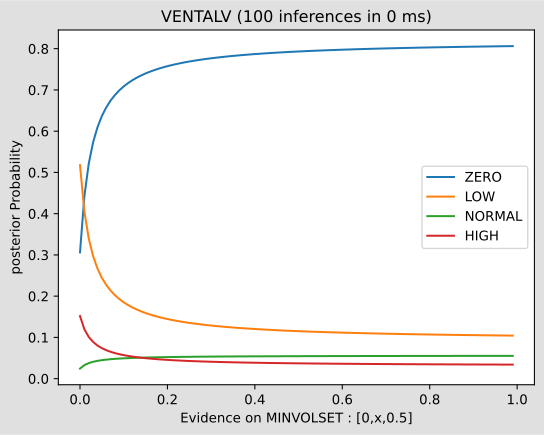
Another example : python gives access to a large set of tools. Here the value for the equality of two probabilities of a posterior is easely computed.
x = [p / 100.0 for p in range(0, 100)]
tf = time.time()y = [  gum.getPosterior(bn, evs={"HRBP": [1.0 - p / 100.0, 1.0 - p / 100.0, p / 100.0]}, target="TPR").tolist()  for p in range(0, 100)]delta = time.time() - tf
plt.plot(x, y)plt.title("HRBP (100 inferences in %d ms)" % delta)v = bn["TPR"]plt.legend([v.label(i) for i in range(v.domainSize())], loc="best")np1 = (np.transpose(y)[0] > np.transpose(y)[2]).argmin()plt.text(x[np1] - 0.05, y[np1][0] + 0.005, str(x[np1]), bbox=dict(facecolor="red", alpha=0.05))plt.show()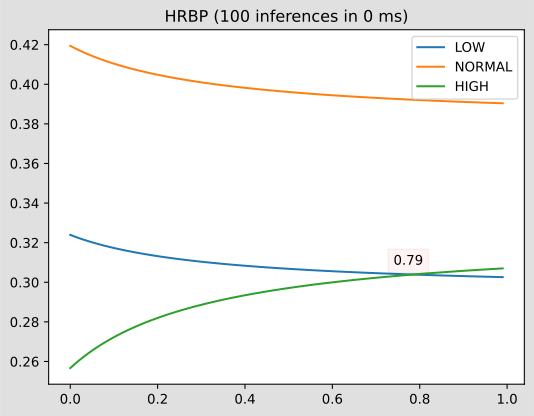
BN as a classifier
Section titled “BN as a classifier”Generation of databases
Section titled “Generation of databases”Using the CSV format for the database:
print( f"The log2-likelihood of the generated base : {gum.generateSample(bn, 1000, 'out/test.csv', with_labels=True):.2f}")The log2-likelihood of the generated base : -15000.71with open("out/test.csv", "r") as src: for _ in range(10): print(src.readline(), end="")ARTCO2,VENTMACH,ANAPHYLAXIS,TPR,LVEDVOLUME,HYPOVOLEMIA,SHUNT,DISCONNECT,PVSAT,BP,SAO2,HISTORY,MINVOLSET,VENTLUNG,HRBP,HREKG,CATECHOL,CVP,ERRLOWOUTPUT,PRESS,INSUFFANESTH,KINKEDTUBE,STROKEVOLUME,HR,LVFAILURE,CO,INTUBATION,FIO2,VENTTUBE,PAP,VENTALV,PULMEMBOLUS,EXPCO2,HRSAT,PCWP,MINVOL,ERRCAUTERHIGH,NORMAL,FALSE,LOW,HIGH,TRUE,NORMAL,FALSE,LOW,LOW,LOW,FALSE,NORMAL,ZERO,LOW,HIGH,HIGH,HIGH,FALSE,HIGH,FALSE,FALSE,LOW,NORMAL,FALSE,LOW,NORMAL,NORMAL,LOW,NORMAL,ZERO,FALSE,LOW,LOW,HIGH,ZERO,FALSEHIGH,NORMAL,FALSE,NORMAL,NORMAL,FALSE,NORMAL,FALSE,NORMAL,LOW,LOW,FALSE,NORMAL,HIGH,LOW,NORMAL,NORMAL,NORMAL,FALSE,HIGH,FALSE,TRUE,NORMAL,NORMAL,FALSE,NORMAL,NORMAL,NORMAL,LOW,NORMAL,LOW,FALSE,HIGH,LOW,NORMAL,LOW,TRUEHIGH,NORMAL,FALSE,HIGH,NORMAL,FALSE,HIGH,FALSE,LOW,HIGH,LOW,FALSE,NORMAL,ZERO,HIGH,NORMAL,HIGH,NORMAL,FALSE,HIGH,FALSE,FALSE,NORMAL,HIGH,FALSE,HIGH,NORMAL,NORMAL,LOW,NORMAL,ZERO,FALSE,LOW,HIGH,NORMAL,ZERO,FALSEHIGH,NORMAL,FALSE,NORMAL,HIGH,FALSE,NORMAL,FALSE,LOW,HIGH,LOW,FALSE,NORMAL,ZERO,HIGH,HIGH,HIGH,HIGH,FALSE,HIGH,FALSE,FALSE,NORMAL,HIGH,FALSE,HIGH,NORMAL,NORMAL,LOW,NORMAL,ZERO,FALSE,LOW,HIGH,HIGH,ZERO,FALSEHIGH,NORMAL,FALSE,NORMAL,NORMAL,FALSE,NORMAL,FALSE,LOW,HIGH,LOW,FALSE,NORMAL,ZERO,HIGH,HIGH,HIGH,NORMAL,FALSE,HIGH,TRUE,FALSE,NORMAL,HIGH,FALSE,HIGH,NORMAL,NORMAL,LOW,NORMAL,ZERO,FALSE,LOW,HIGH,NORMAL,ZERO,FALSEHIGH,NORMAL,FALSE,LOW,NORMAL,FALSE,NORMAL,FALSE,NORMAL,LOW,LOW,FALSE,NORMAL,HIGH,HIGH,HIGH,HIGH,NORMAL,FALSE,HIGH,FALSE,TRUE,NORMAL,HIGH,FALSE,HIGH,NORMAL,NORMAL,LOW,NORMAL,LOW,FALSE,HIGH,HIGH,NORMAL,ZERO,FALSEHIGH,ZERO,FALSE,LOW,NORMAL,FALSE,NORMAL,FALSE,LOW,LOW,LOW,FALSE,NORMAL,ZERO,NORMAL,NORMAL,HIGH,HIGH,FALSE,ZERO,FALSE,FALSE,NORMAL,LOW,FALSE,LOW,NORMAL,NORMAL,ZERO,NORMAL,ZERO,FALSE,LOW,LOW,NORMAL,LOW,TRUEHIGH,NORMAL,FALSE,NORMAL,NORMAL,FALSE,HIGH,FALSE,LOW,NORMAL,LOW,FALSE,NORMAL,ZERO,HIGH,HIGH,HIGH,LOW,FALSE,HIGH,FALSE,FALSE,NORMAL,HIGH,FALSE,NORMAL,NORMAL,NORMAL,LOW,NORMAL,ZERO,FALSE,LOW,HIGH,NORMAL,ZERO,FALSEHIGH,NORMAL,FALSE,HIGH,NORMAL,FALSE,NORMAL,FALSE,LOW,HIGH,LOW,FALSE,NORMAL,ZERO,HIGH,HIGH,HIGH,NORMAL,FALSE,NORMAL,TRUE,FALSE,NORMAL,HIGH,FALSE,HIGH,NORMAL,NORMAL,LOW,LOW,ZERO,FALSE,LOW,HIGH,NORMAL,ZERO,FALSEprobabilistic classifier using BN
Section titled “probabilistic classifier using BN”(because of the use of from-bn-generated csv files, quite good ROC curves are expected)
from pyagrum.lib.bn2roc import showROC_PR
showROC_PR(  bn,  "out/test.csv",  target="CATECHOL",  label="HIGH",  # class and label  show_progress=True,  show_fig=True,  with_labels=True,)
out/test.csv: 0%| |
out/test.csv: 100%|██████████|
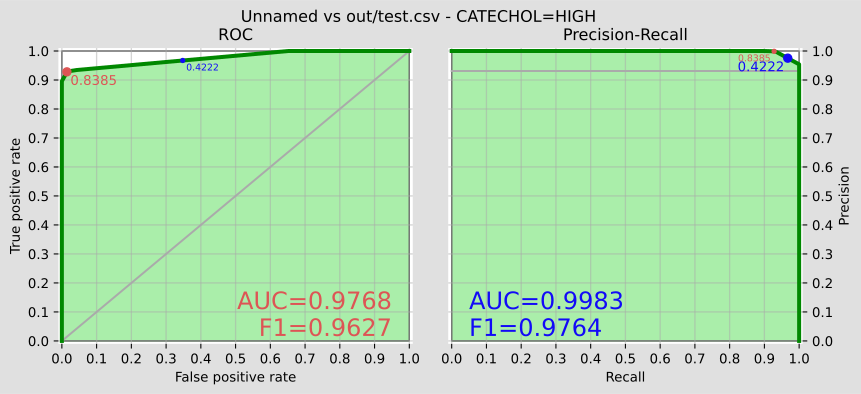
(np.float64(0.949145252214657), np.float64(0.9300899828), np.float64(0.9959010352129366), np.float64(0.4221808066))Using another class variable
showROC_PR(bn, "out/test.csv", "SAO2", "HIGH", show_progress=True)out/test.csv: 0%| |
out/test.csv: 100%|██████████|
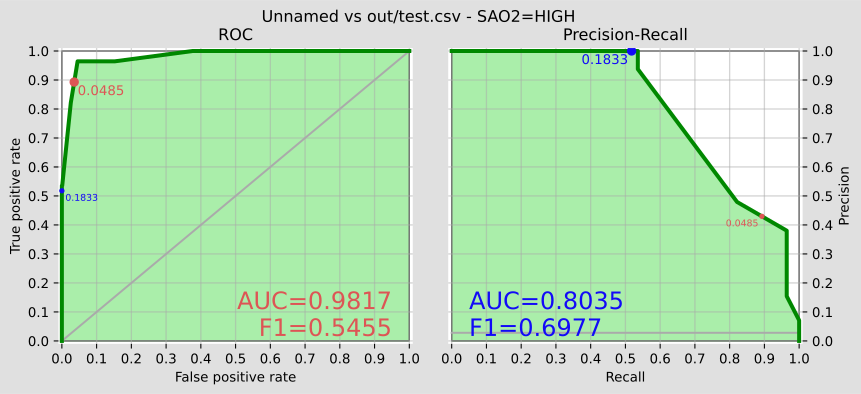
(np.float64(0.16797996011479158), np.float64(0.012257517612538345), np.float64(0.013142647998069768), np.float64(0.012257517612538345))Fast prototyping for BNs
Section titled “Fast prototyping for BNs”bn1 = gum.fastBN("a->b;a->c;b->c;c->d", 3)
gnb.sideBySide( *[gnb.getInference(bn1, evs={"c": val}, targets={"a", "c", "d"}) for val in range(3)], captions=[f"Inference given that $c={val}$" for val in range(3)],)print(gum.getPosterior(bn1, evs={"c": 0}, target="c"))print(gum.getPosterior(bn1, evs={"c": 0}, target="d"))
## using pyagrum.lib.notebook's helpersgnb.flow.row(gum.getPosterior(bn1, evs={"c": 0}, target="c"), gum.getPosterior(bn1, evs={"c": 0}, target="d")) c │0 │1 │2 │─────────│─────────│─────────│ 1.0000 │ 0.0000 │ 0.0000 │
d │0 │1 │2 │─────────│─────────│─────────│ 0.6026 │ 0.0943 │ 0.3031 │|
|
|
|
|---|---|---|
| 1.0000 | 0.0000 | 0.0000 |
|
|
|
|
|---|---|---|
| 0.6026 | 0.0943 | 0.3031 |
Joint posterior, impact of multiple evidence
Section titled “Joint posterior, impact of multiple evidence”bn = gum.fastBN("a->b->c->d;b->e->d->f;g->c")gnb.sideBySide(bn, gnb.getInference(bn))ie = gum.LazyPropagation(bn)ie.addJointTarget({"e", "f", "g"})ie.makeInference()gnb.sideBySide( ie.jointPosterior({"e", "f", "g"}), ie.jointPosterior({"e", "g"}), captions=["Joint posterior $P(e,f,g)$", "Joint posterior $P(e,f)$"],)gnb.sideBySide( ie.evidenceImpact("a", ["e", "f"]), ie.evidenceImpact("a", ["d", "e", "f"]), captions=["$\\forall e,f, P(a|e,f)$", "$\\forall d,e,f, P(a|d,e,f)=P(a|d,e)$ using d-separation"],)gnb.sideBySide( ie.evidenceJointImpact(["a", "b"], ["e", "f"]), ie.evidenceJointImpact(["a", "b"], ["d", "e", "f"]), captions=["$\\forall e,f, P(a,b|e,f)$", "$\\forall d,e,f, P(a,b|d,e,f)=P(a,b|d,e)$ using d-separation"],)Most Probable Explanation
Section titled “Most Probable Explanation”The Most Probable Explanation (MPE) is a concept commonly used in the field of probabilistic reasoning and Bayesian statistics. It refers to the set of values for the variables in a given probabilistic model that is the most consistent with (that maximizes the likelihood of) the observed evidence. Essentially, it represents the most likely scenario or explanation given the available evidenceand the underlying probabilistic model.
ie = gum.LazyPropagation(bn)print(ie.mpe())<d:1|e:0|c:0|b:0|a:1|g:0|f:1>
evs = {"e": 0, "g": 0}ie.setEvidence(evs)vals = ie.mpeLog2Posterior()print( f"The most probable explanation for observation {evs} is \n - the configuration {vals[0]} \n - for a log probability of {vals[1]:.6f}")The most probable explanation for observation {'e': 0, 'g': 0} is - the configuration <g:0|e:0|d:1|f:1|c:0|b:0|a:1> - for a log probability of -2.602178